Cluster Proxmox in alta disponibilità: l'architettura a tre nodi spiegata


Chi mette in produzione Proxmox VE prima o poi si chiede cosa succede quando un server si spegne di colpo, e la risposta del progetto è l'alta disponibilità: le macchine virtuali che giravano sul nodo guasto ripartono da sole sugli altri, senza che qualcuno debba intervenire. Perché questo funzioni, però, non basta installare Proxmox su più server e collegarli fra loro. La documentazione ufficiale dell'alta disponibilità chiede almeno tre nodi e uno storage condiviso, e dietro questi due requisiti ci sono scelte di rete, di storage e di dimensionamento che decidono se il cluster regge davvero un guasto oppure si limita a sembrare ridondante.
In questo articolo spieghiamo perché i nodi devono essere tre, come il cluster decide chi resta attivo, cosa succede minuto per minuto quando un nodo si guasta, quali reti servono e quanto spazio va lasciato libero su ogni server, con i riferimenti alla documentazione di Proxmox per ogni punto.
Perché servono tre nodi
Un cluster Proxmox prende le decisioni a maggioranza. Il Cluster Manager spiega che ogni nodo ha un voto e che, quando la rete si divide, solo la parte che conserva la maggioranza dei voti, cioè il quorum, può continuare a modificare lo stato del cluster, mentre l'altra passa in sola lettura. È il meccanismo che impedisce a due metà isolate di prendere decisioni opposte sulle stesse macchine virtuali.
Con due nodi la maggioranza non esiste: se i due server smettono di vedersi, ciascuno ha un voto su due e nessuno dei due può sapere se l'altro è spento o semplicemente irraggiungibile. Per questo la stessa documentazione indica tre nodi come minimo per un quorum affidabile, e precisa che tutti dovrebbero avere la stessa versione di Proxmox VE. Con tre nodi, se uno si ferma, gli altri due hanno ancora due voti su tre e possono riavviare le sue macchine virtuali in sicurezza.
Per chi ha soltanto due server esiste una via di mezzo, il QDevice: un piccolo servizio che gira su una terza macchina, anche modesta e anche fuori dalla rete del cluster, e fornisce il voto mancante senza ospitare macchine virtuali. La documentazione lo consiglia per i cluster a due nodi e lo sconsiglia per quelli con un numero dispari di nodi, perché lì il suo voto pesa in modo diverso e un suo guasto rende il cluster più fragile invece che più robusto. È una soluzione valida per un piccolo ufficio, ma con due soli nodi ciascun server deve essere in grado di reggere da solo tutto il carico, cosa che con tre nodi non serve.
Come il cluster decide di spostare le macchine
L'alta disponibilità di Proxmox è affidata a due servizi, descritti nella documentazione dell'alta disponibilità: su ogni nodo gira un gestore locale che avvia e ferma le macchine virtuali, e un gestore di cluster prende le decisioni per tutti e sposta le risorse quando qualcosa si guasta. Il punto delicato è che, prima di riavviare altrove una macchina virtuale, il cluster deve essere sicuro che sul nodo guasto non stia più girando.
Il motivo lo spiega bene la documentazione stessa. Se un nodo perde tutte le reti tranne quella dello storage, le sue macchine virtuali continuano a funzionare e a scrivere sui dischi condivisi anche se nessuno le vede più; riavviarle su un altro nodo significherebbe avere due copie della stessa macchina che scrivono sugli stessi dati, con il rischio concreto di rovinarli per sempre. Il meccanismo che evita questa situazione si chiama fencing, e Proxmox lo realizza senza hardware aggiuntivo, con un watchdog: un temporizzatore che il nodo deve azzerare di continuo e che, se non viene azzerato, riavvia il server.
Un nodo che si accorge di aver perso il quorum smette di azzerare il watchdog, e dopo 60 secondi il server si riavvia da solo, con tutte le sue macchine virtuali. A quel punto gli altri nodi sanno che non c'è più nessuna copia in esecuzione e possono ripartire. La documentazione indica tempi tipici di rilevamento e ripresa intorno ai due minuti, e ne trae una conseguenza onesta: con questo meccanismo non si va oltre il 99,999% di disponibilità. Proxmox usa il watchdog hardware della scheda madre se configurato, altrimenti un watchdog software del kernel Linux, che la documentazione definisce affidabile ma meno indipendente dal server.
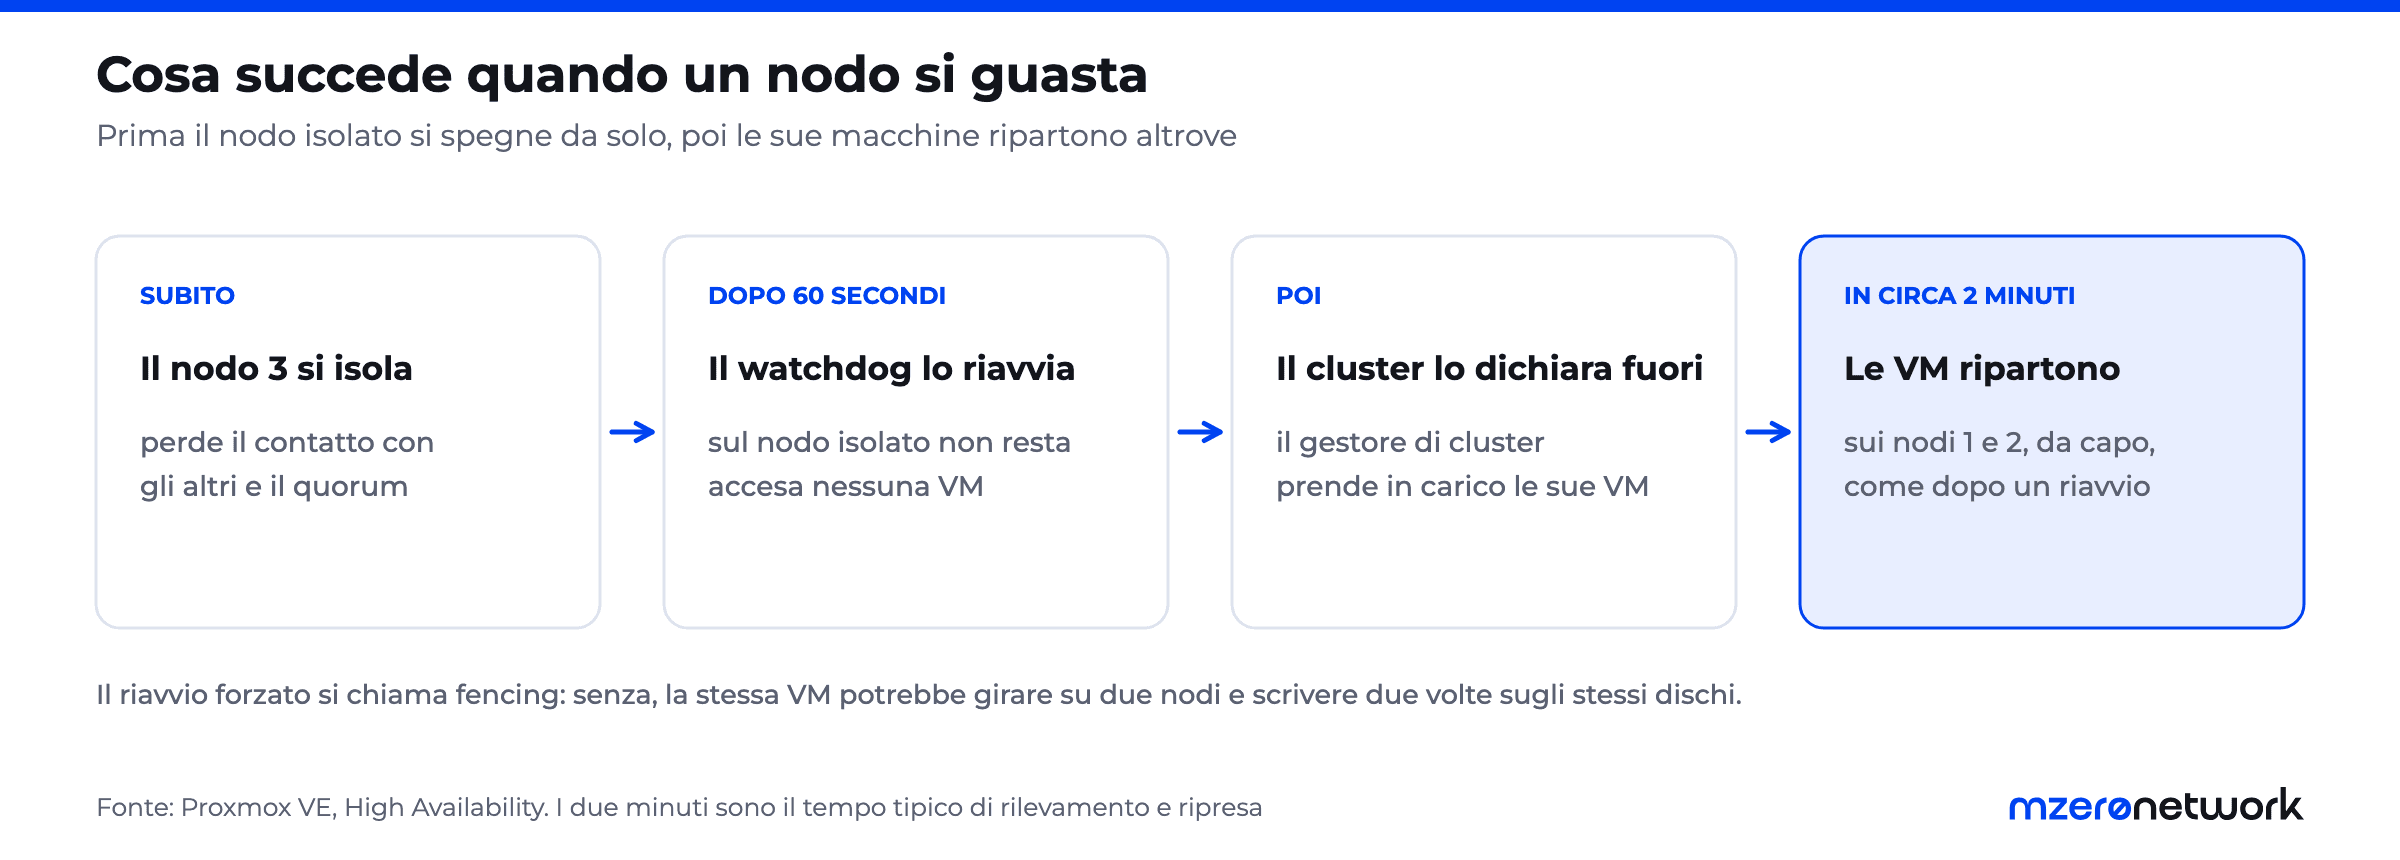
Figura 1. Dal guasto alla ripresa: il nodo isolato si riavvia da solo prima che le sue macchine ripartano altrove, così nessuna gira due volte.
In pratica significa che l'alta disponibilità non elimina il fermo, lo accorcia: le macchine virtuali del nodo guasto si spengono e ripartono da capo su un altro nodo, come dopo un riavvio, e le applicazioni devono sopportarlo. La stessa documentazione mette in fila i numeri: il 99,9% di disponibilità ammette 8,76 ore di fermo all'anno, il 99,99% ne ammette 52,56 minuti. Per servizi che non tollerano nemmeno un riavvio serve una ridondanza a livello applicativo, per esempio un database replicato su più macchine virtuali.
Le reti: la parte che si sbaglia più spesso
Il cluster comunica attraverso Corosync, e il Cluster Manager è molto chiaro sui suoi bisogni: poca banda ma latenza bassa e costante, sotto i 5 millisecondi fra tutti i nodi. Per questo raccomanda una scheda di rete fisica dedicata, per la quale un collegamento da 1 Gbit basta nella maggior parte dei casi, e chiede di non far passare sulla stessa rete lo storage o la migrazione delle macchine virtuali, che con i loro picchi di traffico possono ritardare i messaggi del cluster e fargli perdere il quorum anche senza alcun guasto.
La stessa pagina consiglia di aggiungere un secondo collegamento per Corosync su una rete fisica diversa, così il cluster continua a comunicare anche se la rete dedicata si interrompe; Proxmox ne gestisce fino a otto collegamenti. Un cluster con un solo collegamento, magari condiviso con tutto il resto, è il caso tipico in cui un aggiornamento dello switch o un backup pesante fanno riavviare i nodi uno dopo l'altro.
Se lo storage condiviso è Ceph installato sugli stessi nodi, la soluzione iperconvergente che Proxmox integra, le reti diventano tre. La guida al cluster Ceph iperconvergente raccomanda almeno 10 Gbps riservati al traffico di Ceph, e per le installazioni più esigenti tre reti fisiche separate: una molto veloce, da 25 Gbps o più, per la replica interna di Ceph, una da 10 Gbps o più per il traffico fra Ceph e le macchine virtuali, e una da 1 Gbps riservata a Corosync. Con tre nodi si può fare a meno degli switch veloci collegando i server direttamente fra loro, con la configurazione a maglia completa descritta in una pagina dedicata del wiki.
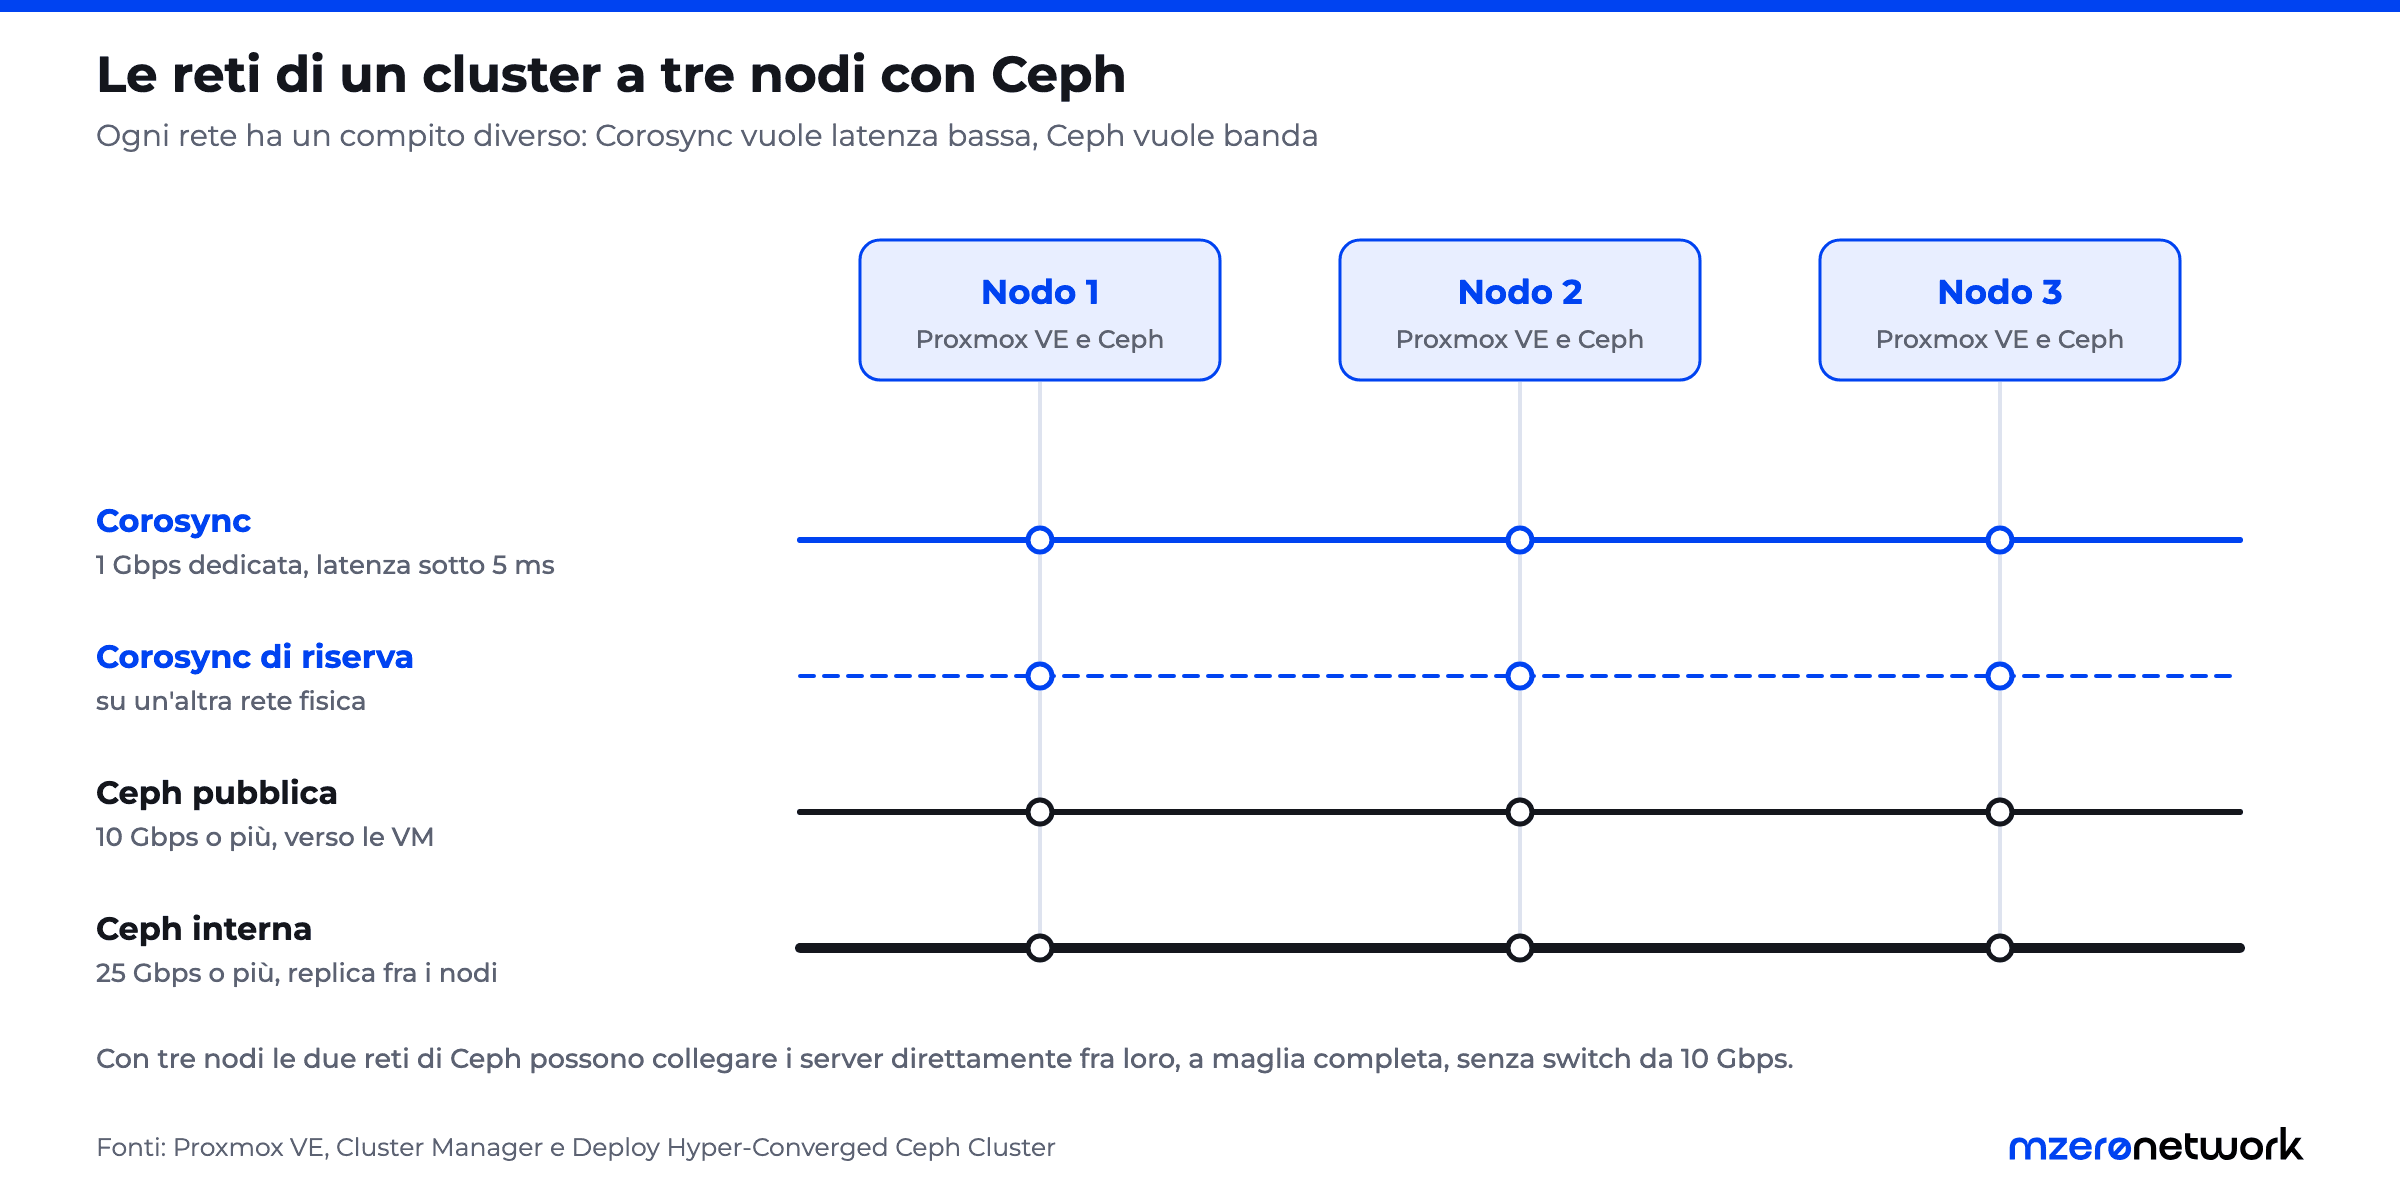
Figura 2. Tre reti con compiti diversi: Corosync vuole latenza bassa, Ceph vuole banda, e mescolarle penalizza entrambi.
Lo storage: Ceph o replica
L'alta disponibilità richiede che i dischi delle macchine virtuali siano raggiungibili da tutti i nodi, altrimenti un nodo superstite non avrebbe niente da avviare. Le strade praticabili con tre nodi sono due.
La prima è Ceph, che tiene più copie di ogni dato su nodi diversi. La guida di Proxmox chiede almeno tre server, preferibilmente identici, e imposta di default tre copie di ogni dato, con un minimo di due per continuare a scrivere; avverte anche di non scendere mai a una copia sola, perché si rischia di perdere dati. Con tre nodi questo significa che il guasto di un nodo lascia tutto funzionante con due copie, mentre il guasto di un secondo nodo blocca le scritture finché le copie non tornano, come spiega il Cluster Manager. La guida aggiunge altre indicazioni che contano: niente controller RAID ma adattatori HBA che lascino a Ceph i dischi interi, dischi SSD nei cluster piccoli per accorciare i tempi di ricostruzione dopo un guasto, e almeno 8 GiB di memoria per ogni disco gestito da Ceph.
La seconda strada è la replica dello storage con ZFS, che copia periodicamente i dischi di ogni macchina virtuale da un nodo all'altro senza bisogno di uno storage condiviso. È più semplice e chiede meno rete, ma la copia non è continua: l'intervallo minimo è di un minuto e quello predefinito di quindici, e la documentazione avverte che in caso di guasto si perdono le modifiche successive all'ultima replica. Per un file server o un gestionale con pochi utenti può essere un compromesso accettabile, per un database con molte scritture di solito no.
In entrambi i casi l'alta disponibilità non sostituisce il backup: protegge da un server che si spegne, non da un file cancellato per errore o da un attacco che cifra i dati su tutte le copie. Per questo un cluster in produzione va sempre affiancato da un backup con Proxmox Backup Server, su una macchina separata.
Come si gestisce quel server di backup nel tempo, dalle verifiche alla copia fuori sede alle prove di ripristino, lo raccontiamo nell'articolo su Proxmox Backup Server in produzione.
Quanto spazio lasciare libero su ogni nodo
È il punto che si dimentica più spesso al momento dell'acquisto. Quando un nodo si guasta, ricorda la documentazione dell'alta disponibilità, le sue macchine virtuali vengono distribuite sui nodi rimasti, che si ritrovano con un carico maggiore, soprattutto nei cluster piccoli; e raccomanda di progettare il cluster perché regga questo caso peggiore.
Con tre nodi il conto è semplice: se uno si ferma, gli altri due devono sostenere da soli tutto il lavoro, quindi in condizioni normali ciascun nodo dovrebbe usare al massimo due terzi della propria memoria e del proprio processore. Un cluster con tre nodi pieni all'80% sembra ben sfruttato finché uno non si guasta, e a quel punto le macchine virtuali che dovrebbero ripartire non trovano posto. La memoria è il vincolo più rigido, perché il processore si può condividere rallentando tutti, mentre una macchina virtuale senza memoria disponibile semplicemente non si avvia.
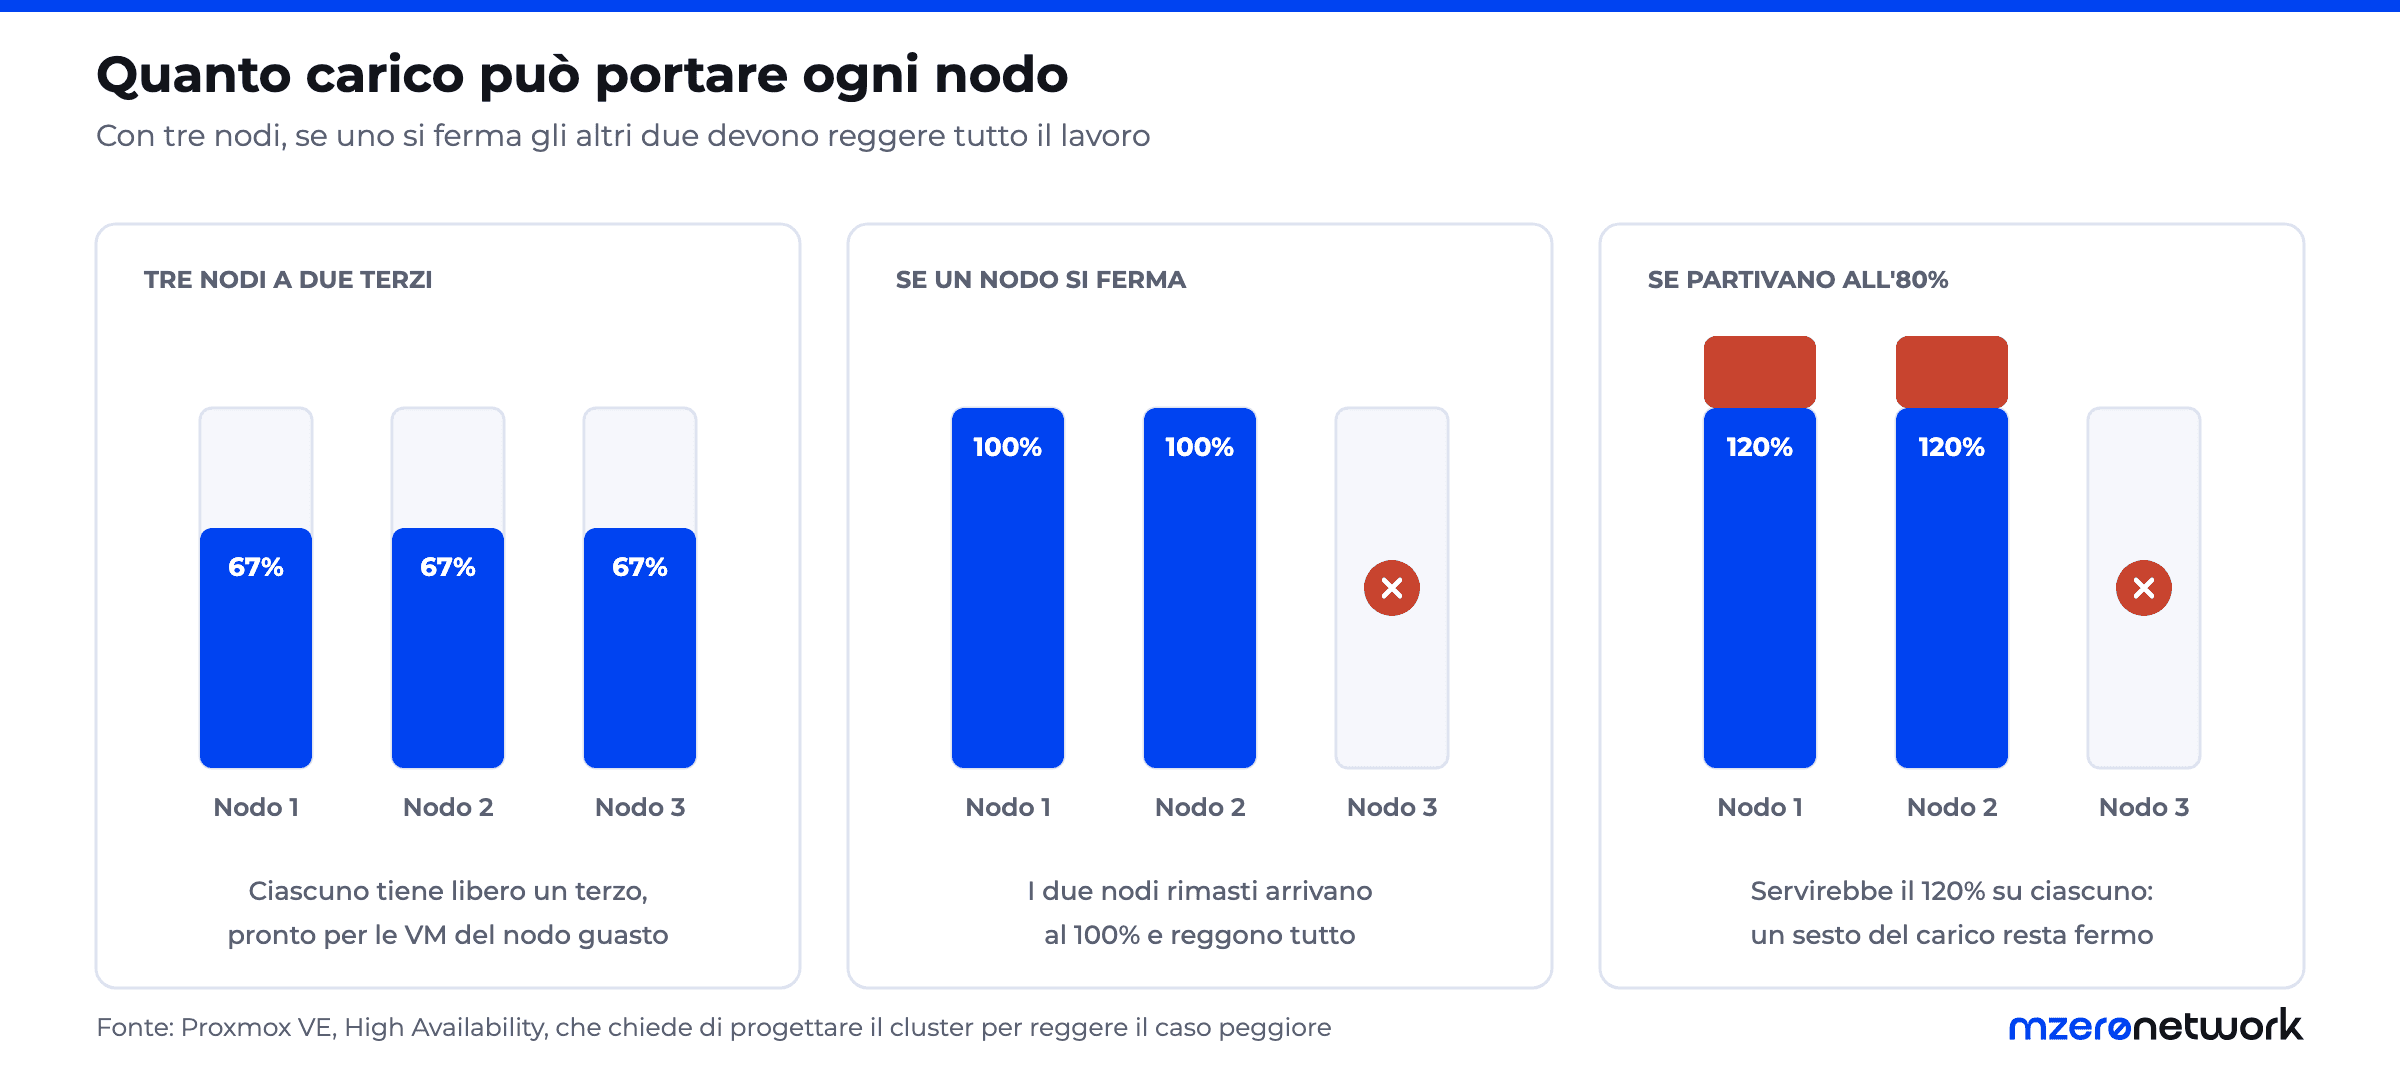
Figura 3. Con tre nodi, ciascuno deve restare entro due terzi della capacità: è lo spazio che serve per accogliere le macchine del nodo guasto.
Lo stesso ragionamento vale per Ceph: dopo il guasto di un nodo le copie mancanti vengono ricostruite sui dischi rimasti, quindi anche lo spazio su disco va tenuto lontano dal limite.
Le verifiche prima di andare in produzione
Un cluster in alta disponibilità si giudica da come si comporta durante un guasto, e il modo più affidabile per saperlo è provocarne uno prima di metterci sopra il lavoro dell'azienda. Le prove indispensabili sono poche e concrete: staccare l'alimentazione di un nodo e misurare quanto tempo impiegano le sue macchine virtuali a ripartire altrove, scollegare la rete di Corosync principale per verificare che il collegamento di riserva prenda il suo posto, controllare che Ceph torni in salute dopo la ricostruzione e che le macchine riavviate funzionino davvero, non soltanto che risultino accese.
Servono anche alcune verifiche meno spettacolari: che tutti i nodi abbiano la stessa versione di Proxmox VE, che il watchdog hardware sia configurato dove la scheda madre lo offre, e che le macchine virtuali critiche siano effettivamente inserite fra le risorse gestite dall'alta disponibilità, perché il cluster sposta solo quelle che gli sono state affidate. Il Cluster Manager ricorda inoltre che la migrazione a caldo è garantita solo fra processori dello stesso produttore, un dettaglio che conviene sapere prima di comprare il terzo nodo.
Se state valutando un cluster nuovo, con la nostra progettazione di cluster Proxmox partiamo dai carichi che deve reggere per dimensionare nodi, reti e storage, e consegniamo il cluster dopo averlo messo alla prova con guasti simulati come questi. Una volta in produzione, l'assistenza Proxmox in abbonamento tiene sotto controllo quorum, Ceph e backup e pianifica gli aggiornamenti un nodo alla volta. Chi ha già un cluster sulla versione 8 trova nell'articolo su Proxmox VE 8 fuori supporto come pianificare il passaggio alla 9, e chi deve scegliere fra sottoscrizione ufficiale e contratto di gestione trova i conti nell'articolo su sottoscrizione Proxmox o contratto di assistenza. Tutti i nostri servizi su Proxmox e VMware sono raccolti nella pagina dedicata alla virtualizzazione e alle infrastrutture server.
Fonti
- Proxmox VE, High Availability, requisiti, gestori locale e di cluster, fencing con watchdog, tempi di ripresa, tabella della disponibilità e ridistribuzione del carico.
- Proxmox VE, Cluster Manager, quorum, numero minimo di nodi, QDevice, requisiti di rete di Corosync, collegamenti ridondanti, effetti di size e min_size di Ceph e migrazione fra processori.
- Proxmox VE, Deploy Hyper-Converged Ceph Cluster, numero di server, reti, copie dei dati, dischi, controller e memoria.
- Proxmox VE, Full Mesh Network for Ceph Server, collegamento diretto fra i nodi senza switch.
- Proxmox VE, Storage Replication, replica con ZFS, intervalli e perdita di dati in caso di guasto.
Stai progettando un cluster Proxmox?
Partiamo dai carichi che deve reggere: dimensioniamo nodi, reti e storage perché un guasto non fermi il lavoro, e ti consegniamo il cluster già provato.